LLM 에이전트 보안 — 루프에서 샌드박스까지
Published:
에이전트에게 셸과 네트워크를 쥐여 주기 전에, 무엇을 어디서 막아야 할까. 이 글은 에이전트 루프를 직접 만드는 데서 출발해, 그 에이전트를 서버에 띄워 두고 운영체제 샌드박스로 가두기까지를 한 흐름으로 정리한다. 다 읽으면 프롬프트 규칙, 하네스 검증, 커널 샌드박스가 각각 무엇을 막고 무엇을 못 막는지, 그리고 샌드박스로도 못 막는 조합은 어디서 끊어야 하는지 설명할 수 있다.
글 전체를 한 문장으로 줄이면 이렇다.
모델은 행동을 요청할 뿐이다. 그 요청을 실행할지는 하네스의 코드가 정하고, 실행된 행동이 어디까지 닿을지는 커널이 정한다.
글의 구성
글은 두 부분으로 나뉜다. 1부는 에이전트를 만드는 법, 2부는 그 에이전트를 가두는 법이다.
| 부분 | 절 | 답하는 질문 |
|---|---|---|
| 1부. 에이전트 만들기 | 1 Agent Loop · 2 Tool · 3 Workflow · 4 RAG · 5 Deep Agent | 모델 호출 하나가 어떻게 에이전트가 되고, 루프 하나로 부족할 때 구조를 어떻게 짜는가 |
| 2부. 에이전트 가두기 | 6 Long-running Agent · 7 Workspace · 8 Always-on · 9 OS Sandbox · 10 Lethal Trifecta · 11 CLI Agent · 12 Production | 계속 떠 있는 에이전트가 닿는 범위를 어떻게 제한하고 측정하는가 |
글 전체에서 쓰는 용어 세 개를 먼저 정해 둔다.
- 하네스(harness): 모델 호출을 감싸는 코드. 메시지 기록을 관리하고, 모델이 요청한 도구를 검증해 실행한다.
- 도구(tool): 이름·설명·입력 스키마·반환값을 갖춘 함수. 도구 호출(tool call)은 그 함수를 실행해 달라는 모델의 구조화된 요청이다. 이 글에서는 ‘도구 요청’이라고도 쓴다.
- 운영자(operator): 에이전트를 배포하고 정책을 정하는 사람. 2부에서는 운영자와 에이전트의 권한 영역이 나뉜다.
1. Agent Loop — 모델은 요청만 한다
핵심: LLM은 루프의 ‘추론’ 칸 하나를 채울 뿐이다. 행동을 실행하는 것은 코드다.
에이전트는 환경을 인지(perception)하고, 무엇을 할지 추론(reasoning)하고, 행동(action)으로 환경을 바꾸는 루프다. 온도 조절기도, 자율주행차도, LLM 에이전트도 같은 루프를 돈다. 차이는 얼마나 많이 인지하는지, 행동이 얼마나 멀리 닿는지뿐이다.
이 루프에서 추론 칸은 갈아 끼울 수 있다. 미로를 푸는 에이전트로 예를 들면, 같은 루프에 “항상 동쪽” 규칙, DFS, BFS, A*, LLM을 차례로 넣을 수 있다. 바뀌는 것은 결정 함수 한 줄이고, 루프 구조와 상태, 행동 단계는 그대로다. 덕분에 두 질문을 따로 다룰 수 있다.
- capability: 추론이 얼마나 뛰어난가
- reach: 행동이 어디까지 닿는가
추론이 아무리 뛰어나도 에이전트는 행동 공간을 통해서만 세상에 영향을 준다. 2부의 샌드박스가 제한하는 것이 바로 이 행동 공간이다.
LLM 호출에 관한 세 가지 사실
여기서는 OpenAI 호환 Chat Completions API를 기준으로 한다. 이 호출의 성질 세 가지가 그 위에 만드는 에이전트의 동작을 결정한다.
- 호출 사이에 상태가 없다. 서버는 요청과 요청 사이에 아무것도 기억하지 않는다. 대화의 “메모리”는 코드가 들고 있다가 매 턴 통째로 다시 보내는
messages배열이다. Responses API는 스레드를 서버에 보관할 수 있지만, 모델 자체가 stateless라는 점은 같다. - 추론 텍스트는 선택 사항이다. 어떤 모델은
reasoning_content에 추론을 돌려주고, 어떤 모델은 답변이나 도구 요청만 돌려준다. finish_reason이 루프의 분기 신호다. 루프는 이 필드를 응답 내용·도구 요청과 함께 읽고 다음 할 일을 고른다.
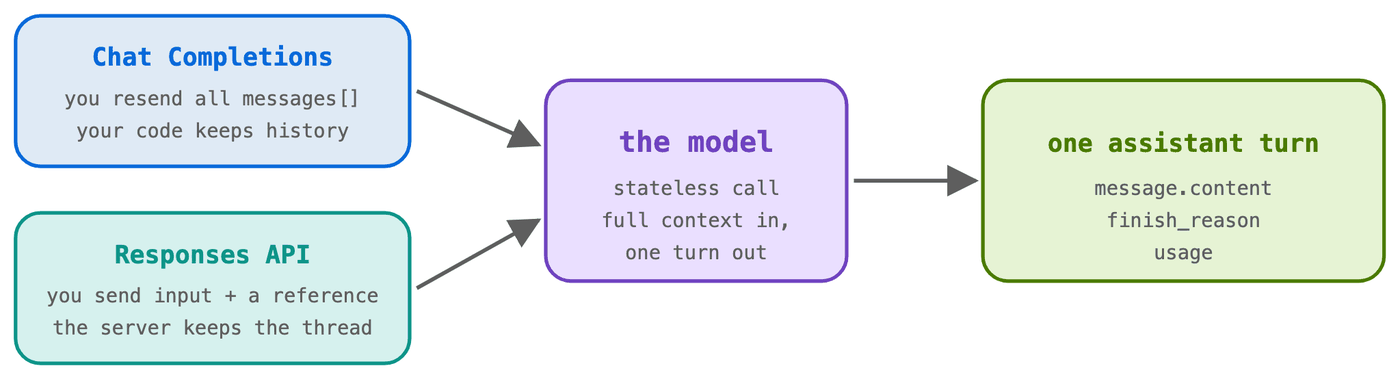 그림 1. 두 API의 차이는 턴 사이에 대화를 누가 보관하느냐뿐이다. 어느 쪽이든 모델은 stateless다.
finish_reason | 의미 | 루프가 할 일 |
|---|---|---|
"stop" | 모델이 최종 답변을 썼다 | content를 사용자에게 반환 |
"tool_calls" | 모델이 함수 실행을 요청했다 | 검증 → 실행 → 결과를 덧붙이고 다시 호출 |
"length" | 답변이 끝나기 전에 토큰 예산이 바닥났다 | 오류로 처리. 잘린 출력을 답으로 쓰지 않는다 |
"content_filter" | 안전 분류기가 출력을 중단했다 | 오류로 처리 |
모델이 돌려주는 것은 행동이 아니라 행동 요청(intent)이다. 미로 예제라면 { "move": "east" } 같은 타입 있는 요청이다. 컨트롤러가 이 요청을 읽고 검증한 다음, 범위가 제한된 업데이트 하나(doMove(...))를 환경에 적용한다. 모델 호출이 이동을 실행하지는 않는다. 그래서 점검할 경계도 두 곳이다. 모델에 들어가는 컨텍스트, 그리고 요청을 적용하기 전에 코드가 하는 검증이다.
ReAct — 추론과 행동을 번갈아
ReAct(Yao et al., 2022)는 reasoning과 acting을 합친 이름이다. 모델이 짧게 추론하고, 도구를 쓰고, 결과를 관찰하고, 다시 추론한다. 논문은 이렇게 번갈아 하는 방식이 추론 없이 행동만 하는 방식보다 여러 작업에서 낫다는 것을 보였다. LangChain의 createReactAgent를 비롯한 대부분의 범용 에이전트 프레임워크가 이 루프를 토대로 삼는다.
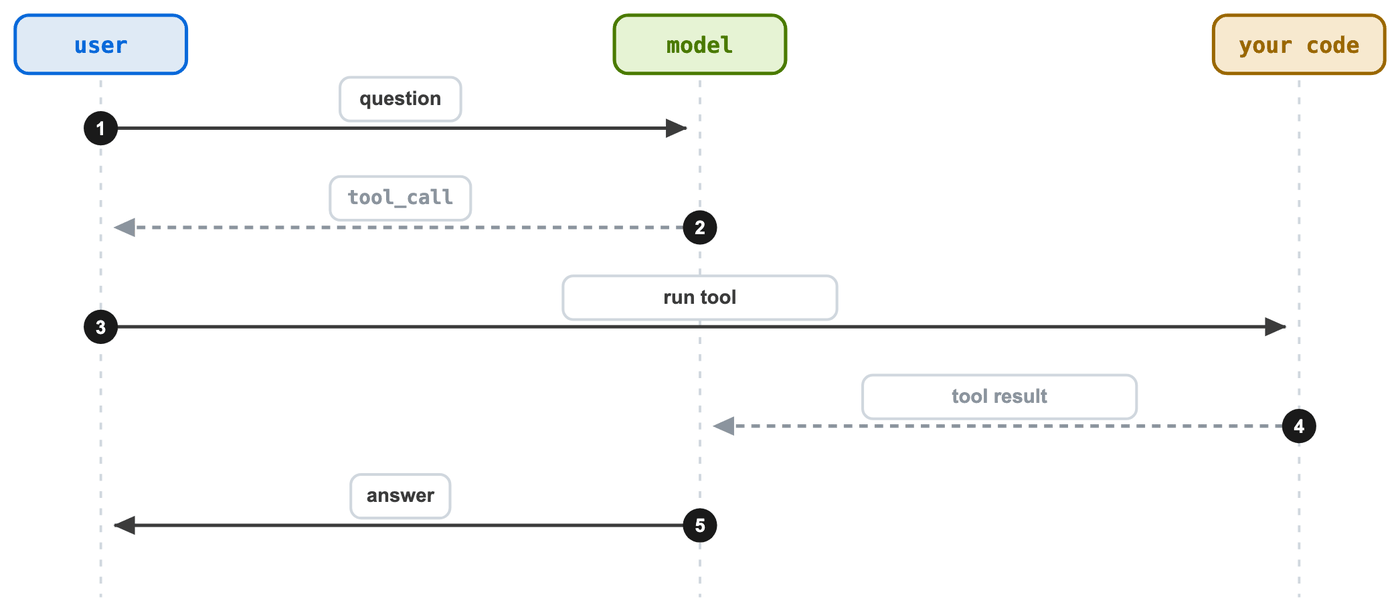 그림 2. 도구 호출 한 바퀴. 모델은
tool_call을 요청하고, 도구를 실행하는 것은 여러분의 코드다.
도구 하나(get_current_time), 시스템 프롬프트 하나, 루프 하나면 ReAct 루프를 처음부터 만들 수 있다. 핵심만 적으면 다음과 같다. chat()은 OpenAI 호환 /chat/completions POST 하나를 감싼 래퍼다.
const TOOLS = [{
  type: "function",
  function: {
    name: "get_current_time",
    description: "Returns the current UTC time as 'YYYY-MM-DD HH:MM:SS UTC'.",
    parameters: { type: "object", properties: {}, required: [] },
  },
}];
const execTool = () => new Date().toISOString().slice(0, 19).replace("T", " ") + " UTC";

const messages = [
  { role: "system", content: "현재 시각이 필요하면 get_current_time을 사용하세요." },
  { role: "user", content: "UTC 기준으로 지금 몇 시인가요?" },
];

for (let step = 1; step <= 12; step++) {                 // 도구 루프 폭주를 막는 상한
  const r = await chat({ model: MODEL, messages, tools: TOOLS });
  const { finish_reason, message } = r.choices[0];
  if (!["stop", "tool_calls"].includes(finish_reason))   // length, content_filter
    throw new Error(`불완전한 턴: ${finish_reason}`);

  messages.push(message);                                 // 도구 요청이 담긴 assistant 턴도 기록
  if (!message.tool_calls?.length) {
    if (!message.content) throw new Error("답변도 도구 요청도 없음");
    return message.content;                               // 최종 답변
  }
  for (const tc of message.tool_calls) {
    const args = JSON.parse(tc.function.arguments || "{}"); // 인자 형식이 깨졌으면 여기서 중단
    if (tc.function.name !== "get_current_time" || Object.keys(args).length)
      throw new Error("예상하지 못한 도구 요청: 실행하지 않음");
    messages.push({ role: "tool", tool_call_id: tc.id, content: execTool() });
  }
}
throw new Error("최종 답변 없이 단계 상한에 도달");
시계를 한 번 읽고 나면 messages에는 네 턴이 쌓인다. 시스템 프롬프트(0), 사용자 질문(1), tool_calls가 담긴 assistant 메시지(2), 함수 반환값을 담은 tool 메시지(3). 다음 호출은 이 네 턴을 모두 받는다. 계속 늘어나는 이 배열이 에이전트가 가진 유일한 메모리다.
Lilian Weng(2023)의 LLM 에이전트 구성도를 이 루프에 대응시키면 역할이 선명해진다.
| 구성 요소 | 이 루프에서 |
|---|---|
| 메모리 | messages 배열 |
| 계획 | 모델이 주어진 컨텍스트로 다음 응답이나 도구 요청을 고르는 순간 |
| 도구 | 하네스가 노출한 함수 |
| 행동 | 하네스가 실제로 실행한 도구 호출 |
루프가 실패하면 구성 요소 사이를 오가는 값을 본다. finish_reason이 예상과 다른지, messages에 빠진 턴이 있는지, 도구 구현이 엉뚱한 값을 돌려줬는지, 분기 코드가 그 값을 잘못 읽었는지.
이 루프로 해 볼 만한 실험이 하나 있다. 시스템 프롬프트에 “반드시 get_current_time을 한 번 호출한 뒤 답하세요”라고 써도 모델이 따른다는 보장은 없다. 프롬프트 지시와 코드로 강제한 제어 흐름은 다르다. 그리고 모델이 도구를 요청했다는 사실만으로는 시계가 실제로 실행됐다는 증거가 되지 않는다. 증거는 messages에 남은 tool 결과다.
Context rot
루프가 길어질수록 모순, 오래된 관찰, 나쁜 관행이 기록에 쌓여 다음 결정이 나빠진다. 이를 context rot이라고 부른다. 위치 효과도 있다. Liu et al.(2023, “Lost in the Middle”)은 모델이 긴 컨텍스트 중간에 묻힌 정보를 잘 활용하지 못한다는 것을 보였다. 완화책은 모두 “결정을 그 근거 가까이 두기”로 모인다.
- 관찰이 쌓이기 전에 계획을 세운다.
- 하위 작업을 위임해 각 서브에이전트가 짧은 컨텍스트에서 일하게 한다.
- 이전 턴이 부담이 되기 전에 요약한다.
2. Tool — 계약은 고정하고 구현은 바꾼다
핵심: 모델이 보는 것은 도구의 계약(이름·설명·스키마)뿐이다. 그 뒤의 구현은 바꿀 수 있지만, 실행 전 검증은 하네스의 몫이다.
도구가 늘어나도 왕복 구조는 그림 2 그대로다. 바뀌는 것은 모델 앞에 놓인 도구의 수와 크기다. 모델은 더 많은 설명 가운데서 골라야 하고, 도구 하나 뒤에 더 큰 기능이 숨을 수 있다. 지킬 규칙은 다섯 가지다.
- 스키마는 보장이 아니다. 입력 스키마는 인자의 이름·타입·필수 필드를 모델에게 설명할 뿐이다. 도구를 실행하지도 않고, 모델이 제안한 인자가 안전하다고 보장하지도 않는다. 실행하기 전에 모델이 요청한 도구 이름을 확인하고, 인자를 파싱하고, 값을 검증한다.
description이 라우팅을 바꾼다. 모델은 이름, 설명, 인자 스키마, 대화 내용,tool_choice제약을 보고 호출을 제안한다. 설명 한쪽을 고치면 모델이 고르는 도구가 달라진다. 모든 에이전트에서 가장 영향력이 큰 프롬프트 엔지니어링 지점 중 하나다.- 이름은 백엔드가 아니라 기능을 말해야 한다.
elasticsearch_glossary_api처럼 백엔드 이름을 딴 도구는, 백엔드를 바꾸면 그 이름을 참조하는 모든 프롬프트를 고쳐야 한다.glossary_search는 호출자에게 필요한 것을 말하므로, 순위 기반 검색이든 전체 문서 검색이든 프롬프트를 건드리지 않고 그 뒤에 둘 수 있다. 같은 계약 뒤에서 구현을 ‘짧은 요약 여러 개 반환’에서 ‘가장 잘 맞는 문서 전체 반환’으로 바꿔도 루프와 프롬프트는 그대로다. - 서브에이전트도 도구 하나 뒤에 둘 수 있다. 호출하는 모델에게 서브에이전트는 계약 하나일 뿐이다. 그 뒤에서 데이터베이스를 쿼리하거나 코드를 실행해도 메인 루프의 도구 목록은 작게 유지된다. 단, 이것은 컨텍스트 분리이지 접근 제어가 아니다. DB에서 읽은 원본 데이터가 메인 에이전트의 컨텍스트에 바로 들어가지 않을 뿐, 서브에이전트의 답변에는 섞여 나올 수 있다. 서브에이전트 답변의 오류도 그대로 메인 모델의 근거가 된다.
- tool discovery는 신뢰 경계다. 다른 프로세스가 알려 주는 도구 목록은 그 자체로 외부에서 들어온 입력이다.
MCP — 다른 프로세스의 도구를 가져올 때
MCP(Model Context Protocol)는 도구 제공 방식에 표준 형태를 준다. 에이전트는 tools/list로 서버의 도구 카탈로그를 받고, 고른 도구를 tools/call로 호출한다. 메시지 형식은 JSON-RPC다. 도구는 별도 프로세스에 있고 프로토콜은 어디서나 같으므로, 에이전트는 서버마다 새 인터페이스를 익히지 않아도 된다. 기준은 이렇다. tool discovery와 호출에 공통 프로토콜이 필요하면 MCP를 쓰고, 하네스가 기능의 위치와 호출법을 이미 안다면 로컬 함수나 스킬, 직접 API 호출로 충분하다.
tools/list 응답은 신뢰할 수 없는 입력으로 다룬다. 원격 서버를 연결하기 전에 확인할 것은 다음과 같다.
- 서버가 주장하는 그 서버가 맞는지 검증한다.
- 서버가 요청하는 기능을 사용자에게 보여 준다.
- 필요한 최소 권한(scope)만 준다.
- 각 자격 증명을 그 서버의 audience에 묶는다.
- 원격 연결과 OAuth discovery 과정에서 사설·링크 로컬 주소를 거부하고, 모든 리디렉션을 검증한다. 검증 없이 따라가는 URL은 SSRF(Server-Side Request Forgery, 서버 측 요청 위조) 경로가 된다.
MCP 보안 모범 사례 문서도 동의, 토큰 처리, SSRF 통제를 클라이언트의 책임으로 규정한다.
3. Workflow — 관찰에 반응할 것인가, 미리 계획할 것인가
핵심: 다음 단계가 가장 최근 관찰에 달려 있으면 루프를, 분기와 합류 지점을 실행 전에 알 수 있으면 워크플로를 쓴다.
워크플로 에이전트는 하네스가 작업 그래프를 제어하는 시스템이다. 그래프의 노드는 모델 호출, 결정론적 코드, 도구 호출, 전문가 에이전트다. 대표 패턴 두 개를 “모델이 언제 결정하는가”로 비교하면 차이가 분명해진다.
| ReAct (Yao et al., 2022) | ReWOO (Xu et al., 2023) | |
|---|---|---|
| 모델이 결정하는 시점 | 매 관찰 직후 | 도구를 실행하기 전, 한 번에 |
| 실행 방식 | 추론 → 도구 → 관찰을 반복 | 계획 → 결정론적 실행(흔히 병렬) → 종합 |
| 강한 경우 | 경로가 중간 결과에 따라 달라질 때 | 단계들이 서로 독립일 때 |
| 약한 경우 | 한꺼번에 실행할 수 있는 단계를 하나씩 돌 때 | 나중 단계가 앞 단계 결과에 반응해야 할 때 |
ReWOO는 Reasoning WithOut Observation의 줄임말이다. 계획 단계에서 도구 결과를 전혀 보지 않기 때문이다. 조사 질문 하나를 검색 여러 번으로 푸는 ReWOO 파이프라인은 세 단계로 돈다.
- Planner: 스키마로 제약한 LLM 호출 한 번이 검색 쿼리 3~5개를 JSON 목록으로 만든다.
- Executor: 일반 코드다. 모든 쿼리를
Promise.all로 동시에 실행하고, LLM은 호출하지 않는다. - Synthesizer: 두 번째 LLM 호출이 모든 결과를 읽고, 각 검색을 번호로 인용하며 보고서를 쓴다.
LLM 호출은 모두 두 번이고, 검색 N개가 병렬로 돈다. 두 패턴은 섞을 수도 있다. ReAct 루프 안의 도구가 계획된 파이프라인을 돌릴 수 있고, 계획된 단계 하나가 중간 결과에 적응해야 하면 그 단계 안에서 ReAct 루프를 부를 수 있다.
고객 지원 문의에 판단 규칙을 대 보면 이렇다. “같은 구독료가 두 번 청구되었습니다”라는 문의에서, ReAct 루프는 조회 결과를 하나 읽을 때마다 다음 행동을 고른다. 워크플로는 결제 확인과 계정 이력 점검을 독립 분기로 동시에 돌리고, 두 분기의 근거를 합친다.
에이전트를 나누는 데는 비용이 든다. 경계가 하나 늘 때마다 모델 호출 지연과 라우팅 로직이 붙고, 잘못된 형식의 메시지가 생길 지점이 하나 늘고, 읽기 쉬운 타임라인 하나가 여러 에이전트의 로그로 흩어진다. 그래서 나누기 전에 지연 시간과 답변 품질을 측정해야 한다. 장애 격리도 명시적으로 설계해야 한다. 분기를 Promise.all로 모으면 분기 하나만 실패해도 전체가 거부(reject)된다.
라우팅 패턴은 두 가지가 기본이다.
- 고정 enum 분류: 분류 에이전트가 문의를
billing,technical,account,other중 하나로 분류하고, 선택된 전문가 하나에게 넘긴다. 모델이 목록 밖의 값을 내면 라우터는 추측하지 말고 거부하거나 더 엄격한 지시로 재시도한다. 스키마로 출력을 제약하더라도 라우터가 값을 다시 검증해야 한다. - fan-out: 입력 하나를 각자 다른 시스템 프롬프트를 가진 여러 전문가에게 동시에 보낸다. wall time은 가장 느린 전문가가 정한다.
4. RAG — 벡터 DB보다 번들을 먼저 정한다
핵심: 검색 시스템의 목적은 질문에 필요한 근거를 돌려주는 것이다. 벡터 DB를 고르기 전에 무엇을 돌려받아야 하는지부터 정한다.
RAG는 검색을 누가, 언제 하느냐에 따라 세 단계로 나뉜다.
- 검색 없이 생성: 모델의 현재 컨텍스트와 학습 내용만으로 답한다.
- Traditional RAG: 답을 생성하기 전에 매번 고정된 검색 단계를 돈다.
- Agentic RAG: 검색을 도구로 노출하고, 추가 조회가 필요한지는 루프가 정한다.
RAG(Retrieval-Augmented Generation)라는 이름은 Lewis et al.(2020)에서 나왔다. 원래 설계는 retriever와 generator를 손실 하나로 end-to-end 공동 학습시켰다. 쿼리 인코더는 generator가 쓸 만한 구절을 찾도록, generator는 자기 기억보다 검색된 근거에 기대도록 함께 학습했다. inference API 위에서 만드는 요즘의 RAG에는 이 역전파가 없다. 가중치를 건드릴 수 없으니, 고정된(frozen) 모델 앞에서 retriever가 프롬프트에 넣을 구절을 고를 뿐이다. 대신 generator를 학습시키지 않고도 검색 방식을 바꿔 가며 결과를 확인할 수 있다.
파이프라인은 타임라인 두 개로 나뉜다. 오프라인에서는 모든 구절을 한 번 임베딩해 인덱스를 만든다. 실시간 경로에서는 질문을 임베딩하고, 가장 가까운 K개(top-K) 구절을 찾아 질문과 함께 모델에 넘긴다.
번들부터 정의한다
번들(bundle)은 파이프라인이 주고받도록 설계한, 완결되고 범위가 정해진 컨텍스트 묶음이다. 단일 턴 질의응답이라면 질문, 검색한 청크 몇 개, 답변이면 된다. 자율 에이전트라면 여러 턴에 걸쳐 유지하는 작업 메모리 전체, 즉 제약 조건, 이전 결정, 중간 결과, 도구 인터페이스, 운영 규칙이 번들이다. 번들을 먼저 정해 두면 후보 검색 방식이 그 번들을 제공할 수 있는지로 고를 수 있다.
| 데이터 형태 | 예시 | 후보 검색 방식 |
|---|---|---|
| 비정형 텍스트 | 문서, 기사, 코드 주석, 대화 기록 | dense vector 검색 + cross-encoder reranking |
| 계층형 문서 | 법률 계약서, 기술 매뉴얼, 중첩 명세 | 부모 포인터를 갖춘 트리 인덱스 |
| 정형 테이블 | 고객 기록, 재무 원장, 인사 테이블 | 원천 데이터 위의 시맨틱 레이어 |
| 관계형·그래프 | 조직도, 코드 의존성, 지식 그래프 | 그래프 탐색(Cypher, GraphQL 등) |
벡터 검색의 실체와 함정
“벡터 데이터베이스”가 하는 일의 핵심은 단순하다. 구절마다 임베딩을 저장해 두고, 쿼리 임베딩과 코사인 유사도가 가장 높은 K개를 돌려준다. 브라우저 JavaScript 30줄이면 충분하다. 뼈대만 적으면 이 정도다.
const cosine = (a, b) => {
  let dot = 0, na = 0, nb = 0;
  for (let i = 0; i < a.length; i++) { dot += a[i] * b[i]; na += a[i] ** 2; nb += b[i] ** 2; }
  return dot / (Math.sqrt(na) * Math.sqrt(nb));
};

// index: [{ text, vec }] — 오프라인에서 '구절(passage)'용으로 임베딩해 둔 구절
const topK = (index, queryVec, k = 3) =>
  index.map(p => ({ ...p, score: cosine(p.vec, queryVec) }))
       .sort((a, b) => b.score - a.score)
       .slice(0, k);
단순한 만큼 함정도 구체적이다.
- 쿼리와 구절은 다르게 임베딩한다. 일부 임베딩 모델은 질문을 그 질문에 답하는 구절과 짝짓도록 비대칭으로 학습되어, 요청마다 입력이 쿼리인지 구절인지(
input_type: "query"/"passage"같은 값)를 함께 받는다. 둘을 뒤바꿔도 API 오류는 나지 않고, 검색 품질만 조용히 떨어진다. - 인덱스는 임베딩 모델 출력의 캐시다. 임베딩 모델을 바꾸면 모든 구절을 다시 임베딩하기 전까지 캐시된 벡터가 전부 무의미해진다. 제공자가 모델을 조용히 업그레이드하면 오류 없이 점수가 달라진다. 두 서비스가 인덱스 하나를 공유하면서 서로 다른 모델 ID를 고정하면, 한쪽은 엉뚱한 결과를 받는다. 처방은 벡터마다 임베딩 모델 ID를 함께 저장하고, 버전이 섞이면 거부하는 것이다.
- top-K는 항상 K개를 돌려준다. 모든 점수가 낮아도 마찬가지다. 구절을 프롬프트에 넣기 전에 점수 같은 신호를 확인해야 한다.
- 청크 크기는 재현율과 정밀도를 맞바꾼다. 짧은 청크는 임베딩을 좁은 구절에 집중시키지만 답에 필요한 맥락이 빠질 수 있다. 긴 문서는 주제 여러 개가 임베딩 하나에 섞여 매칭이 흐려진다. 해법 하나는 small-to-big retrieval이다. 작은 자식 청크로 검색하고, 매칭되면 부모 문서 전체를 생성 단계에 넘긴다.
검색 인덱스를 retrieve(question, k) 도구로 감싸면 3단계인 agentic RAG가 된다. 모델이 검색할 가치가 있는지 판단하고, 호출하면 top-K 구절이 tool 메시지로 붙고, 두 번째 호출이 그 구절에 근거해 답한다. 도구 인터페이스는 그대로 두고 인메모리 코사인 검색만 서버 측 파이프라인(FAISS 벡터 검색 + BM25 키워드 검색 + reranking)으로 바꿀 수도 있다.
top-K가 맞지 않는 질문: GraphRAG
top-K 검색은 local 질문에 맞는다. “이 계약서의 해지 조건은?”처럼 답이 구절 몇 개 안에 있는 질문이다. “문서 천 개의 주요 주제는?” 같은 global 질문은 다르다. 답이 어느 한 구절에도 없고, 코퍼스 전체를 볼 때만 드러난다. K를 3으로 두면 생성 단계는 고른 구절 세 개만 보므로 다른 곳의 주제를 놓친다.
GraphRAG(Edge et al., 2024)는 K를 늘리는 대신 문제의 형태를 바꾼다. 인덱싱 시점에 LLM으로 entity와 관계를 뽑아 지식 그래프를 만들고, 조밀하게 연결된 커뮤니티를 찾아, 커뮤니티마다 요약해 둔다. 질문이 오면 관련 커뮤니티 요약들로 부분 답을 만들고 하나로 합친다(reduce). 유사도 조회가 아니라 구조 위의 맵리듀스다. 다만 커뮤니티 요약도 그룹화와 요약 품질을 따로 평가해야 한다.
5. Deep Agent — 새 컨텍스트는 샌드박스가 아니다
핵심: 근거가 대화 하나에 담기지 않을 만큼 커지면 서브에이전트마다 새 컨텍스트를 주고 결과는 파일로 넘긴다. 단, 컨텍스트 격리는 보안 경계가 아니다.
단일 ReAct 루프는 모든 지시와 관찰을 기록 하나에 담는다. 질문이 커지면 그 기록이 문제가 된다. 실패는 세 가지 모습으로 온다.
- overflow: 근거와 도구 출력이 컨텍스트 윈도를 넘친다.
- context rot: 관련 근거가 있는데도 충분히 반영되지 않는다.
- interference: 한 분기의 추론이 다음 분기를 방해한다.
Deep research 에이전트는 이를 네 단계로 푼다. 오케스트레이터가 질문을 독립 작업으로 나누고(계획), 서브에이전트(워커)마다 다른 분기의 기록이 빠진 새 컨텍스트에서 작업 하나를 맡기고(조사), 결과를 공유 가상 파일 시스템에 기록하게 하고(보존), 저장된 결과를 읽어 각 주장이 어느 분기에서 왔는지 추적할 수 있는 답을 만든다(종합). 각 서브에이전트가 받는 것은 원래 질문, 할당된 작업, 필요한 도구뿐이다.
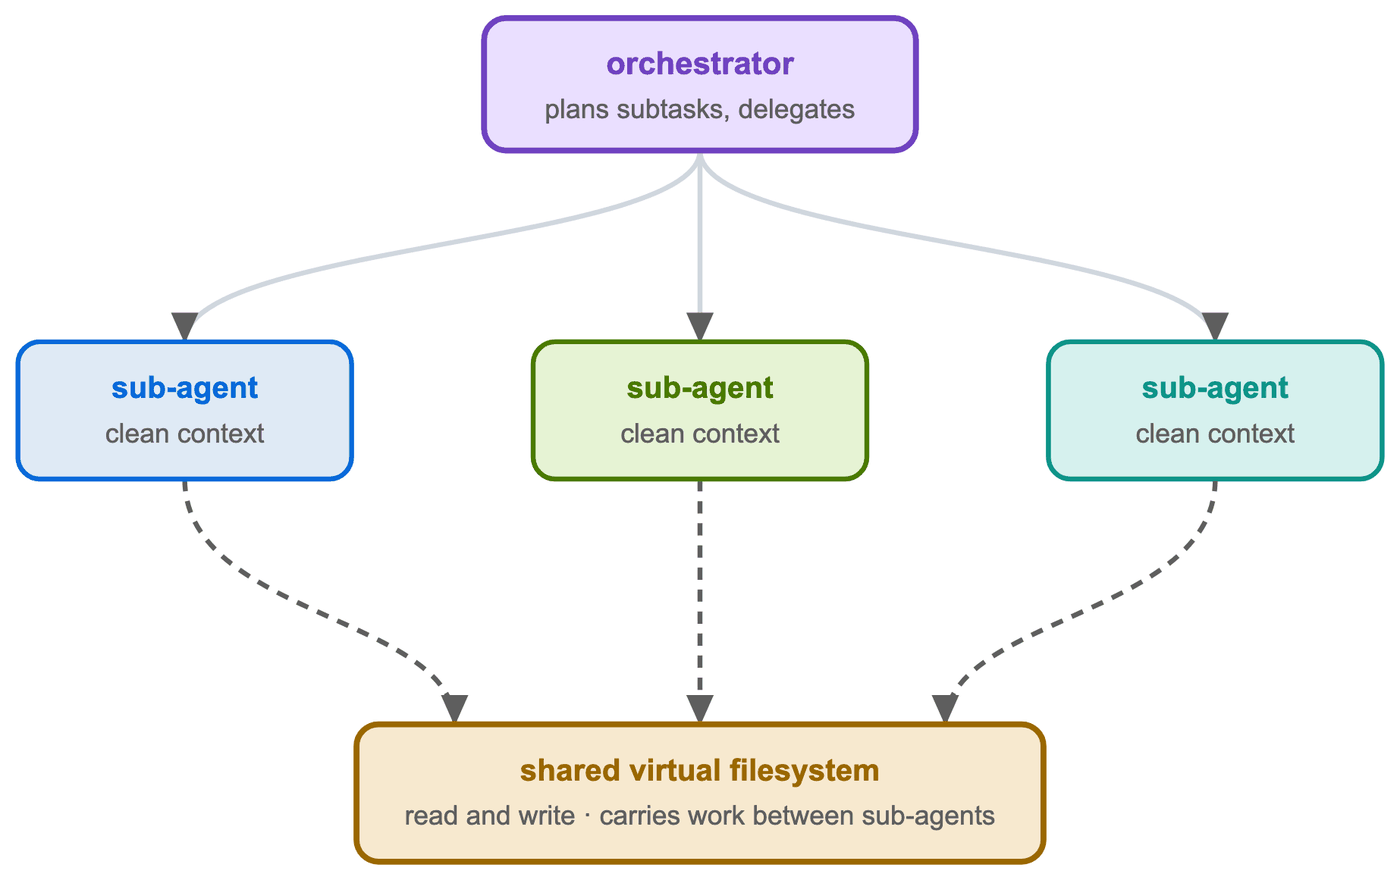 그림 3. Deep agent의 구조. 서브에이전트들은 서로의 기록을 보지 않고, 결과는 공유 파일 시스템으로만 오간다.
여기서 두 가지를 분명히 해 둔다.
- 새 컨텍스트는 샌드박스가 아니다. 컨텍스트 격리는 분기들의 추론을 떼어 놓고, 샌드박스는 운영체제 접근을 제한한다. 둘은 서로 다른 실패를 막는다.
- 파일에 남았다고 검증된 것은 아니다. 검색 도구 없이 모델 지식만으로 초안을 쓰는 서브에이전트라면, 파일에 보존되는 것은 초안이지 독립적으로 검증된 근거가 아니다.
구현 쪽에서는 LangChain의 createReactAgent({ llm, tools })가 1절의 루프를 모델 노드와 도구 노드로 된 그래프로 바꾸고, deepagents 패키지가 계획·가상 파일 시스템·서브에이전트 패턴을 감싸 제공한다. 기준은 “단순한 루프로 필요한 제어 흐름을 더는 표현할 수 없을 때 그래프를 쓴다”이다.
6. Long-running Agent — 기록은 서버에, 제어권은 토큰에
핵심: 에이전트가 서버에서 계속 돌면 대화 기록은 런타임으로 옮겨 가고, 실행 중인 에이전트를 조종하는 control plane이 새로 생긴다. 보안의 초점도 “모델이 무엇을 말하나”에서 “누가 이 런타임을 조종할 수 있나”로 옮겨 간다.
1부의 에이전트는 브라우저 탭이나 스크립트 안에서 돌았다. 탭을 닫으면 메시지와 중간 결과도 함께 사라졌다. 계속 떠 있는 에이전트는 역할이 넷으로 나뉜다.
| 역할 | 하는 일 |
|---|---|
| 모델 | 프롬프트와 도구 결과를 응답으로 바꾼다 |
| 하네스 | 세션 기록, 파일 기반 워크스페이스, 도구 접근을 유지한다 |
| 샌드박스 | 실행 중인 에이전트가 닿는 범위를 제한한다 |
| 배포 구성 | 하네스와 샌드박스가 함께 동작하도록 묶는다 |
이 중 상태를 가진 것은 하네스뿐이다. 모델은 여전히 stateless다.
인터페이스는 세 층으로 나뉜다
떠 있는 에이전트를 다루는 인터페이스는 모델을 직접 부르던 것과 다르다.
- 모델 API: 1부의 직접 호출. 요청과 응답 한 쌍으로 범위가 끝난다.
- 도구 프로토콜(MCP): 런타임 안에서 도구와 컨텍스트의 discovery와 호출을 표준화한다.
- control plane: 실행 중인 에이전트에게 메시지를 넣고, 세션·cron 작업·설정을 관리하는 운영자용 인터페이스다.
세션 ID — 클라이언트는 기록을 보내지 않는다
1부의 클라이언트는 매 턴 messages 배열 전체를 다시 보냈다. 서버에서 도는 런타임의 클라이언트는 세션 ID만 보낸다. 런타임이 매 호출 전에 그 ID로 서버 측 기록을 찾아 루프를 돌린다. ID가 다르면 대화도 분리된다.
여기서 기록과 파일의 수명이 갈린다. 세션을 초기화하면 대화 기록은 지워지지만, 워크스페이스 파일은 남는다. 그리고 그 파일은 다음 실행의 컨텍스트로 다시 들어간다.
Control plane 토큰은 곧 운영자 권한이다
control plane 토큰은 모델 API 키와 성격이 다르다. 모델 키가 모델을 부를 권리라면, control plane 토큰은 에이전트를 부릴 권리다. 토큰 하나로 사람 없이 도는 작업을 예약하고 실행 중인 루프에 메시지를 곧바로 넣을 수 있다면, 그 토큰을 읽을 수 있는 사람은 누구나 운영자가 된다. 토큰이 에이전트가 실행되는 환경에 놓여 있다면, 그 환경을 읽을 수 있는 모든 사람이 해당한다.
7. Workspace — 파일이 곧 프롬프트다
핵심: 요즘 에이전트는 페르소나와 규칙, 기억을 마크다운 파일로 둔다. 에이전트가 그 파일을 고칠 수 있다면, 이번 대화가 아니라 다음 실행이 바뀐다.
하네스는 워크스페이스의 파일을 읽어 각 턴의 컨텍스트에 넣는다. Claude Code의 CLAUDE.md, Codex CLI의 AGENTS.md, Cursor의 .cursor/rules/*.mdc, 스킬 폴더의 SKILL.md가 모두 이 패턴이다. 역할별로 파일을 나누는 워크스페이스라면 대략 이런 구성이 된다.
| 파일의 역할 | 담는 것 |
|---|---|
| 페르소나 | 정체성, 경계, 어조, 가치관 |
| 운영 규칙 | 작업 지침과 금지 사항 |
| 사용자 정보 | 사용자가 누구인지, 선호 사항 |
| 도구 메모 | 도구별 사용법과 주의점 |
| 주기 작업 | 정해진 주기마다 확인할 체크리스트 |
| 일일 로그 | 작업하며 덧붙이는 원본 메모 |
| 장기 메모리 | 로그에서 추려 오래 남기는 기억 |
| 스킬 | 필요할 때 불러 쓰는 지침 묶음 |
어떤 파일이 프롬프트의 어느 부분을 채우는지 정해져 있으므로, 파일을 고치기 전에 그 수정이 어떤 동작을 바꿀지 예측할 수 있다.
메모리를 두 계층으로 두면, 에이전트는 일일 로그에 원본 메모를 덧붙이고 오래 남길 부분만 추려 장기 메모리로 옮긴다. 장기 메모리를 공유 대화나 그룹 대화의 컨텍스트에서 빼는 식의 설정은 컨텍스트 구성상의 선택일 뿐, 파일 접근 제한이 아니다.
자기 보고를 파일과 대조한다
에이전트의 말은 파일과 맞춰 본 뒤에 믿는다. 절차는 세 단계다.
- 에이전트에게 자신의 워크스페이스 파일과 각 파일의 역할을 설명하게 한다.
- 샌드박스 바깥의 운영자 셸에서 같은 파일을 직접 읽어 비교한다.
- 에이전트에게 고유 라벨을 붙인 메모를 장기 메모리에 추가하게 한다. 새 대화에서 에이전트가 그 메모를 읽게 하기 전에, 운영자가 파일을 직접 열어 라벨을 확인한다. “저장했습니다”라는 응답만으로는 근거가 되지 않는다.
이 절차에서 권한 영역이 두 개라는 것이 드러난다. 운영자 셸은 샌드박스 바깥에서 운영자 권한으로 돌고, 에이전트는 같은 머신에서 더 좁은 정책 아래 돈다.
안전 측면의 의미는 분명하다. 워크스페이스 컨텍스트를 다시 쓸 수 있는 에이전트는 이후의 실행에 영향을 준다. 그 밖에 무엇에 닿는지는 파일 시스템·네트워크 규칙이 정하므로, 실제 정책에서 호스트 파일 시스템, 외부 네트워크, 이웃 에이전트의 워크스페이스에 대한 접근을 확인해야 한다.
8. Always-on — 사람 없이 도는 트리거
핵심: cron 작업과 heartbeat는 사람이 지켜보지 않는 실행을 만든다. 세션을 격리해도 파일은 공유되므로, 오염된 지시가 대화 하나를 넘어 살아남을 수 있다.
실행을 시작하는 메커니즘은 세 가지로 나눠 볼 수 있다.
- session: 실행이 누구의 컨텍스트를 이어받는가
- directive: 지침이 어디서 오는가. 파일이거나 예약된 메시지다
- trigger: 실행이 언제 시작되는가
이 세 가지로 흔한 메커니즘 네 개를 분류하면 아래와 같다. 구체적인 세션 바인딩은 런타임과 설정에 따라 달라진다.
| 메커니즘 | session | directive | trigger |
|---|---|---|---|
| 스킬 | 호출자의 세션을 재사용 | 스킬 폴더의 SKILL.md | 명시적 요청 또는 자동 선택 |
| heartbeat | 메인 세션 | 주기 작업 체크리스트 파일 | 런타임의 주기 타이머 |
| cron | 실행마다 새로 만든 격리 세션 | cron 작업에 담긴 메시지 | 예약 시각 |
| 서브에이전트 | 새 세션, 부모가 핸들을 보유 | 부모가 준 작업 지침 | 부모 에이전트가 턴 도중에 결정 |
사람 없이 실행이 일어났는지는 이렇게 확인한다. 1회성 cron 작업을 걸어 두고, 채팅 메시지 없이 기대한 파일이 생기는지 실행 기록과 대조한다. 작업은 실행 후 스스로 지워지게 하고, 실패하거나 중간에 멈춘 경우에도 자기가 만든 작업을 정리한다.
위험도 여기서 생긴다. “일일 보고서를 보내라”는 예약된 지시는 사람이 지켜보든 말든 실행된다. 격리 세션이라면 이전 대화 기록은 이어지지 않지만, 공유 파일은 이후 실행에 여전히 영향을 준다. 재사용 가능한 지침을 쓰고, 작업을 예약하고, 원격 메시지를 받을 수 있는 하네스는 오염된 지시를 대화 하나를 넘어 지속시킬 수 있다.
누가 에이전트에게 말을 걸 수 있는지도 따로 통제해야 한다. 메시징 연동을 제공하는 Hermes Agent는 페어링 코드와 플랫폼별·전역 사용자 허용 목록을 두고, 일치하는 규칙이 없으면 default: deny를 적용한다. 이런 애플리케이션 수준의 통제가 정하는 것은 누가 에이전트와 대화할 수 있는가다. 도구가 무엇에 닿을 수 있는가는 운영체제 샌드박스가 따로 제한한다. 기능 이름이 같다고 위험 통제도 같다고 가정하면 안 된다.
9. OS Sandbox — 막는 것은 모델이 아니라 커널이다
핵심: 프롬프트는 의도를, 하네스는 요청을, 샌드박스는 결과를 다룬다. 앞의 둘이 모두 뚫려도 커널은 작업이 끝나기 전에 거부할 수 있다.
방어 계층 세 개
신뢰할 수 없는 콘텐츠가 에이전트에게 “자격 증명을 읽어 외부로 보내라”고 지시하는 상황을 떠올려 보자. 세 계층이 각각 막을 기회를 가지며, 각자 다른 질문에 답한다.
| 계층 | 하는 일 | 한계 |
|---|---|---|
| 프롬프트 | 의도를 형성한다. 예: “자격 증명을 공개하지 마라” | 적대적 검색 콘텐츠, 악의적 도구 출력, 루프 안의 다른 에이전트에게 속을 수 있다. 에이전트의 권한은 그대로다 |
| 에이전트 하네스 | 요청을 검증한다. 지원하지 않는 셸 형식, 금지된 도구 호출, 잘못된 인자를 거부한다 | 결정론적이지만 결국 애플리케이션 로직이다. 잘못 설정되거나, 낡거나, 침해될 수 있다 |
| 샌드박스 | 결과를 제한한다. 정책이 허용한 권한만 프로세스에 준다 | 앞의 둘이 실패해도 파일·네트워크·프로세스 작업을 완료 전에 거부할 수 있다. 다만 허용된 행동의 의미는 보지 못한다 |
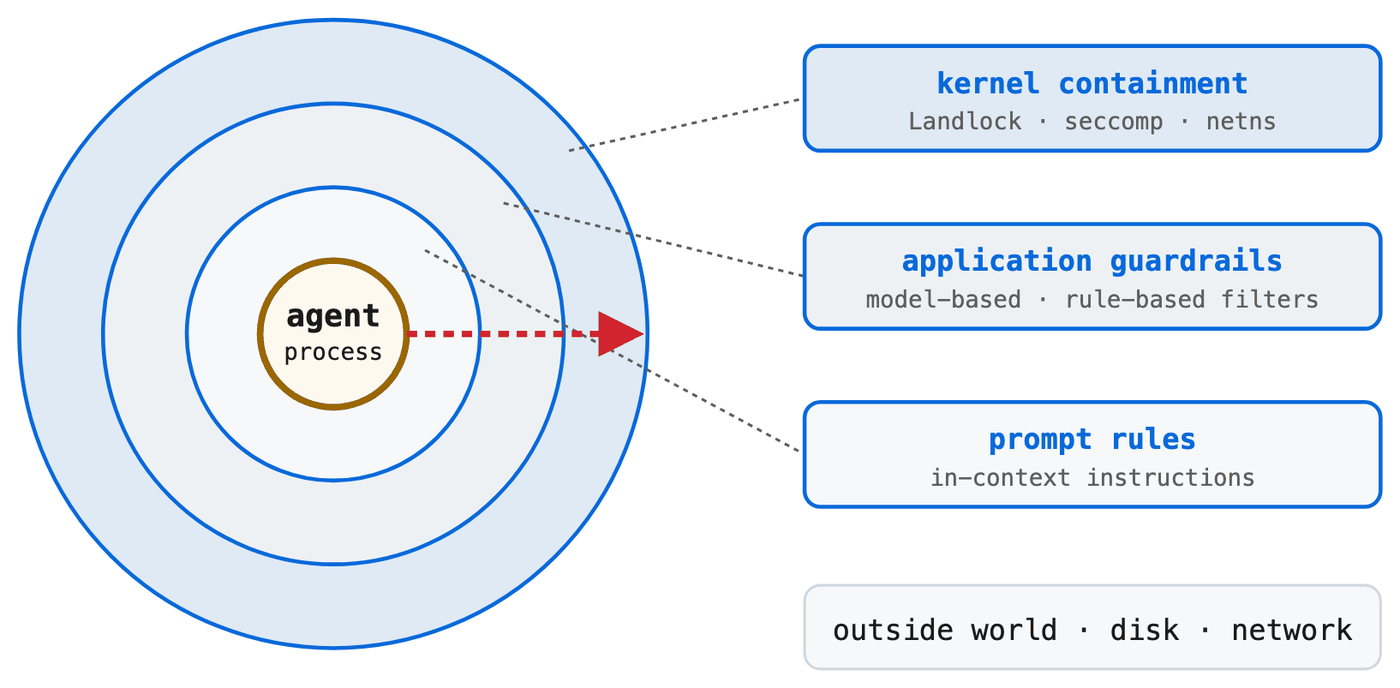 그림 4. 방어 계층. 가장 바깥의 커널 격리(Landlock·seccomp·netns)가 에이전트와 바깥 세계 사이의 마지막 경계다.
통제를 모델이 아니라 커널에 두는 근거는 원칙 세 개다.
- 제로 트러스트: 요청이 어디서 왔는지만 보고 암묵적으로 신뢰하지 않는다(NIST SP 800-207). OWASP의 프롬프트 인젝션 가이드는 이를 에이전트에 적용해, 도구와 권한을 제한하고 외부 콘텐츠가 모델을 조종할 수 있다고 가정하라고 한다.
- 최소 권한: 각 구성 요소는 자기 작업에 필요한 권한만 받는다(Saltzer & Schroeder, 1975). 에이전트보다 오래된 원칙이라 그대로 적용된다.
- 의도를 증명하지 말고 경계를 측정한다: 라이스 정리에 따르면 임의 프로그램의 비자명한 동작을 판정하는 일반적 검사는 존재할 수 없다. 코드를 실행하는 에이전트도 마찬가지다. 정적 검사로 앞으로의 모든 행동이 안전하다고 증명하려 하지 말고, 실행되는 대상 주변의 경계를 계측한다.
메커니즘 네 개, 테스트할 질문 네 개
리눅스에서는 운영체제 메커니즘 몇 가지를 겹쳐 샌드박스를 만든다. 대표적인 조합은 다음 네 가지이고, 메커니즘마다 테스트할 수 있는 질문이 하나씩 있다.
| 질문 | 메커니즘 | 동작 | 주의할 점 |
|---|---|---|---|
| 어디에 연결할 수 있는가 | 네트워크 네임스페이스(netns) + HTTP CONNECT 프록시 + OPA | 격리된 네트워크 스택에서 외부 접근은 처음에 닫혀 있다. 프록시가 유일한 출구이고, OPA가 요청한 바이너리·호스트·포트·경로를 정책과 대조한다 | 정책을 편집하는 사람이 어떤 연결을 허용할지 정한다 |
| 어떤 파일에 접근할 수 있는가 | Landlock | 새 파일 작업을 정책이 허용한 경로로 제한한다 | 호환 모드, OverlayFS, 제한 전에 열린 핸들은 따로 따져야 한다 |
| 어떤 커널 작업을 요청할 수 있는가 | seccomp | BPF 필터가 시스템 콜을 허용 목록과 대조한다. 거부된 호출은 실행 전에 EPERM을 받는다. ptrace, mount, setuid 같은 위험한 호출을 막는다 | 필터가 보는 것은 시스템 콜 번호와 인자뿐이다 |
| 처음에 권한이 얼마나 있는가 | 권한 없는 전용 사용자(non-root) | 공격이 성공해도 낮은 권한에서 시작하므로 blast radius가 줄어든다 | 권한 상승이 불가능하다는 증명은 아니다 |
넷 다 특정 제품의 기능이 아니라 리눅스 커널과 오픈소스의 기본 부품이다. Landlock은 권한 없는 프로세스가 스스로 이후의 파일 접근을 제한할 수 있게 하는 LSM(Linux Security Module)으로, 커널 5.13부터 들어왔다. BPF는 커널 안에서 도는 작은 필터 프로그램이고, EPERM은 “operation not permitted”를 뜻하는 errno다. OPA(Open Policy Agent)는 구조화된 입력을 평가해 허용·거부 결정을 돌려주는 오픈소스 정책 엔진이다.
관찰 결과를 읽는 법
샌드박스를 시험할 때 가장 먼저 새길 문장은 이것이다. 명령 결과만으로는 어떤 메커니즘이 막았는지 알 수 없다. 명령이 실패한 원인은 정책일 수도, 설치되지 않은 소프트웨어일 수도, 잘못된 요청이나 서비스 자체일 수도 있다. HTTP 오류도 프록시가 냈는지 대상 애플리케이션이 냈는지 출처부터 확인해야 한다.
경계는 이런 질문과 명령으로 두드려 볼 수 있다.
| 질문 | 점검 명령 예 |
|---|---|
| 어떤 네트워크 요청이 완료되는가 | curl https://example.com, curl https://en.wikipedia.org, curl http://169.254.169.254/latest/meta-data/(클라우드 인스턴스 메타데이터 주소) |
| 요청한 소프트웨어를 설치할 수 있는가 | apt-get install -y cowsay, pip install cowsay, npm install left-pad |
| 더 많은 권한을 요청하면 어떻게 되는가 | sudo id, nsenter -t 1 -m -- id, docker ps, dd if=/proc/1/environ of=/dev/null |
| 지침 파일의 소유자는 누구인가 | ls -la로 페르소나·지침 파일의 소유자 확인, 일회용 파일로 chmod 실험 |
마지막 질문에는 함정이 있다. 파일을 읽기 전용 모드(0444)로 바꿔도 소유자는 모드를 되돌릴 수 있고, 파일 삭제도 파일 모드로는 막히지 않는다. 에이전트가 페르소나 파일의 소유자라면 파일 모드는 보호 수단이 되지 못한다. 페르소나를 지키려면 정책, 호스트가 관리하는 파일 보호, 검토 가능한 변경 이력이 필요하다.
해석 절차는 “예측 → 실측 → 비교”다. 활성 정책을 먼저 읽고, 그 정책으로 요청 결과를 예측한 뒤, 같은 요청을 샌드박스 안에서 실제로 실행해 비교한다. 결과가 일치해도 뒷받침되는 것은 테스트한 그 행동에 대한 예측뿐이다. 모든 정책 규칙이 증명되지는 않는다. 불일치하면 요청, 활성 정책, 응답의 출처, 예측에 쓴 가정을 점검한다.
실패한 단계만 봐서는 안 된다. 허용된 명령이 출력한 비밀 정보는 이미 출력 채널에 도달했다. 나중의 네트워크 거부가 앞서 일어난 노출을 되돌리지는 못한다.
샌드박스 바깥의 control plane
샌드박스 정책은 에이전트 프로세스의 파일·네트워크·시스템 콜을 제한한다. 6절의 control plane은 그 바깥에 있다. control plane 토큰으로 페르소나, 일정, 세션, 모델, 구성을 읽고 바꿀 수 있다면, 그것은 egress(밖으로 나가는 트래픽) 규칙이 결코 보지 못하는 권한 상승 경로다. 읽기 테스트만으로는 쓰기 권한을 확인할 수 없으므로, 토큰의 범위와 보관 위치는 샌드박스 정책과 별도로 점검한다.
10. Lethal Trifecta — 샌드박스가 보지 못하는 것
핵심: 따로 떼어 보면 모두 허용된 권한이 한 에이전트 안에서 만나면 공격 경로가 된다. 세 요소 중 하나만 끊어도 경로가 사라진다.
Simon Willison(2025)이 이름 붙인 lethal trifecta는 다음 세 가지가 한 에이전트에 모이는 상황이다.
- 비공개 데이터: 에이전트가 읽을 수는 있지만 유출해서는 안 되는 것. 워크스페이스 파일, 이메일, 토큰, 메모리, 내부 기록.
- 신뢰할 수 없는 입력: 운영자가 쓰지 않았지만 모델이 지시로 받아들일 수 있는 콘텐츠. 웹 페이지, 이슈, 문서, 도구 결과, 동료 에이전트의 응답.
- 외부 통신: 바이트를 밖으로 내보낼 수 있는 모든 경로. HTTP, 풀 리퀘스트, 채팅, 로그 한 줄, 이미지 로드, 사용자가 클릭할 수 있는 링크까지.
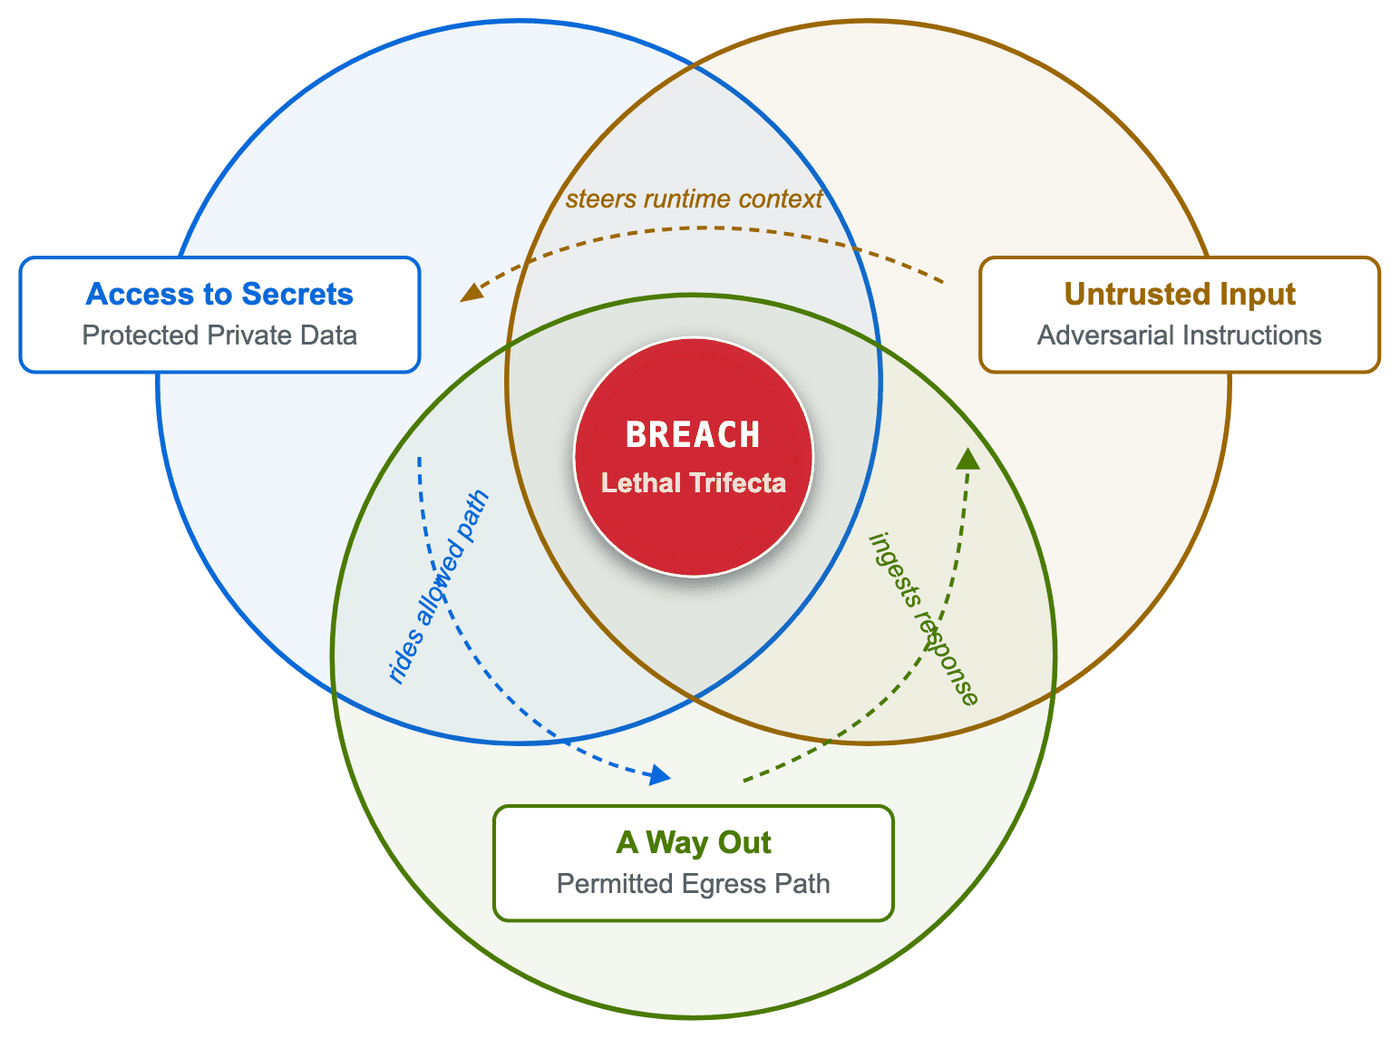 그림 5. Lethal trifecta. 적대적 입력이 런타임을 조종해(steers runtime context) 보호된 데이터를 읽고, 허용된 경로를 타고(rides allowed path) 내보낸 뒤, 응답을 다시 받아들인다(ingests response).
정책이 외부 엔드포인트 하나를 올바르게 허용했더라도 그 엔드포인트는 양방향이다. 요청이 나가고, 응답이 새 입력으로 돌아온다. 적대적 콘텐츠가 모델을 조종하면 비공개 데이터를 읽어 샌드박스가 허용한 채널로 내보낼 수 있다. 네트워크 허용 목록은 목적지를 승인할 뿐, 그 연결을 지나가는 바이트의 의미까지 승인하지는 않는다. 거꾸로 말하면, 하네스나 애플리케이션 계층에서 세 요소 중 하나만 끊어도 공격에 필요한 경로가 사라진다.
실제 구성에서 점검할 실패 유형은 여섯 가지다.
- 페르소나 변조: 에이전트가 페르소나·지침 파일을 고칠 수 있는가
- control plane 권한: 토큰 범위와 서버 구성이 어떤 관리 기능을 허용하는가
- 인바운드 인젝션: 허용된 채널로 적대적 지시가 들어올 수 있는가
- 허용된 채널을 통한 유출: 허용된 엔드포인트가 유출 경로가 될 수 있는가
- 숨겨진 의도: 하나하나는 허용된 행동들이 모여 해로운 워크플로가 되는가
- peer protection: 동료 에이전트에 대한 판정이 사회적 맥락에 따라 흔들리는가
실패 유형별로 샌드박스가 기여하는 부분과 그 위에 여전히 필요한 통제를 나누면 다음과 같다. 분류는 OWASP Top 10 for Agentic Applications를 따른다.
| 실패 유형 | 샌드박스의 기여 | 그 위에 여전히 필요한 통제 |
|---|---|---|
| goal hijacking·프롬프트 인젝션 | 모델이 조종된 뒤 닿을 수 있는 파일·프로세스·목적지를 제한 | 입력 출처 추적, 고위험 행동에 대한 승인, 행동 평가 |
| 도구 오용 | 도구가 실행되는 OS·네트워크 범위를 제한 | 도구별 권한, 인자 검증, 속도 제한, 되돌릴 수 없는 호출 확인 |
| identity·권한 남용 | non-root 사용자로 시작, 일부 권한 상승 경로 차단 | 워크로드별 identity, 최소 토큰 범위, 짧은 유효 기간, 주기적 교체(rotation), 감사 |
| 공급망 공격·예기치 않은 코드 실행 | 설치된 코드가 쓸 수 있는 파일·시스템 콜·egress 축소 | 버전 고정, 검증된 의존성, 설치 정책, 무결성 모니터링 |
| 메모리·컨텍스트 오염 | 정책으로 읽기 전용 지정 시 선택한 파일 보호 | 쓰기 출처 추적, 검토 가능한 이력, 신뢰 레이블, 알려진 정상 상태로 복구 |
계층 하나가 모든 피해를 알아차리길 기대하지 말고, 이 표로 통제 지점을 고른다. 커널이 의미를 볼 수 없는 결정은 여전히 애플리케이션과 운영 관행이 책임진다.
11. CLI Agent — 열어 준 권한만큼 공격 표면이 넓어진다
핵심: CLI를 고르면 시작 기본값이 정해진다. 그 기본값이 어디까지 닿을지는 CLI를 감싸는 샌드박스와 정책이 정한다.
Claude Code, Codex CLI, Cursor, Hermes는 모두 같은 기능 몇 가지를 감싼다. 작업 디렉터리, 도구 세트, 메모리, 사람의 입력 없이 실행하는 선택적 수단(cron 작업, 오래 걸리는 작업, 큐 작업), 네트워크. 보안 특성은 어떤 기능이 기본으로 열려 있는지, 사람 없이 도는 실행이 켜져 있는지, 아래 런타임이 잘못된 호출을 잡아낼 수 있는지에 달려 있다.
| 제품 | 지침 파일 | 실행과 승인의 기본값 |
|---|---|---|
| Claude Code | CLAUDE.md | 도구 규칙, 권한 모드, 샌드박스 설정이 무엇이 바로 실행되고 무엇이 승인을 거치는지 정한다 |
| Codex CLI | AGENTS.md | 샌드박스 설정이 접근을 제한하고, 승인 정책이 검토를 제어한다. 그 한도 안의 편집과 명령은 자동 실행될 수 있다 |
| Cursor | .cursor/rules/*.mdc | 워크스페이스 편집은 대체로 승인 없이 실행되고, 터미널 명령은 기본적으로 승인이 필요하다 |
| Hermes | 스킬, 영구 메모리 | 승인 모드와 터미널 백엔드가 명령 처리와 격리 수준을 정한다. 메시징 연동을 제공한다 |
어떤 CLI를 쓰든 운영자가 열어 주거나 막을 항목은 같다. 항목마다 점검할 질문과 보수적인 기본값의 예를 정리하면 다음과 같다.
| 항목 | 점검할 질문 | 보수적인 기본값의 예 |
|---|---|---|
| 파일 시스템 | 어떤 경로를 읽고 쓸 수 있는가 | 작업 디렉터리와 임시 디렉터리에만 쓰기 허용. 시스템 경로는 읽기 전용 |
| 네트워크 egress | 어떤 바이너리가 어떤 호스트·포트·HTTP 메서드·경로로 나갈 수 있는가 | 기본 거부(default deny). 꼭 필요한 목적지(모델 inference API, 패키지 저장소 등)만 허용하고, 항목마다 요청 형태와 바이너리를 좁힌다 |
| 실행 사용자 | 에이전트가 어떤 사용자로 실행되는가 | 권한 없는 전용 사용자. ptrace, mount, setuid 같은 시스템 콜 차단 |
| 실행 파일 식별 | 어떤 실행 파일이 권한을 쓰는가 | 실행 파일 경로와 해시로 판별(TOFU, trust-on-first-use). argv[0]은 위조될 수 있으니 믿지 않는다 |
| 지속성 | 예약 작업, 스킬, 페르소나 파일을 누가 바꿀 수 있는가 | 소유권과 호스트 측 파일 보호로 에이전트의 변경을 막고, 변경 이력을 남긴다 |
| inference 라우팅 | 어떤 컨텍스트가 어떤 모델 엔드포인트로 나가는가 | inference 요청을 관리형 게이트웨이로 모으고, 무엇이 밖으로 나갈지는 에이전트가 아닌 운영자 정책이 정한다 |
egress 허용을 바이너리에 묶으면, 같은 호스트라도 어떤 실행 파일이 요청했는지에 따라 허용 여부가 달라진다. 허용 목록이 목적지만 보는지, 호출한 프로그램까지 보는지 확인해 둘 만하다.
이런 차이는 harness weight라는 말로 묶을 수 있다. 기준은 세 가지다. 하네스가 숨기는 추상화(작성할 코드는 줄지만 실제로 무엇이 실행되는지 덜 보인다), 내장된 가정과 기본값(사용자가 요청하기 전에 하네스가 어디까지 손을 뻗는가), 기본 제공 기능(직접 구현할지, 제공되는 것을 쓸지)이다.
마지막으로, 중지는 되돌리기가 아니다. 브라우저에서 JavaScript를 실행하는 도구 하나만 가진 에이전트를 생각해 보자. 중지 버튼은 모델 요청을 취소하고 이후의 도구 호출을 막지만, 이미 실행 중인 동기 JavaScript를 멈추거나 완료된 행동을 되돌리지는 못한다.
12. Production — 모델 호스팅, 데이터, 다음 단계
핵심: 실제 배포에는 자체 데이터와 사용자가 더해진다. 모델을 어디서 돌릴지, 지식을 어떻게 가져올지, 무엇을 더 깊게 팔지 고른다.
- 모델 호스팅: 호스팅된 API를 쓸지, 온프레미스나 VPC에서 셀프 호스팅할지 정한다. 데이터가 밖으로 나갈 수 없는 환경이라면 셀프 호스팅이 필요하다. 어느 쪽이든 선택한 모델이 도구 호출과 구조화된 출력을 지원하는지 먼저 확인한다.
- 자체 데이터: 인메모리 코사인 검색을 넘어서면, sparse(키워드) 검색과 dense(벡터) 검색을 병렬로 돌려 점수를 합치고 reranker로 다시 정렬하는 hybrid search를 많이 쓴다. 중복 제거나 필터링 같은 코퍼스 정제는 자신의 검색 작업으로 효과를 평가한다. 정제가 모든 답변을 개선한다는 보장은 없다.
- 가드레일: 모델 위 애플리케이션 계층의 입출력 필터와 주제 정책은 커널 격리를 대체하지 않고 보완한다. 두 계층은 서로 다른 실패를 잡으므로 함께 쓴다.
- 다음 단계: 지금 반복해서 부딪히는 문제에 맞는 주제를 하나 고른다. 지식 계층(구조적 청킹, 페이지 이미지 검색, 답변 faithfulness 평가), 프로토콜 계층(MCP, Responses API, OpenTelemetry GenAI 규약, A2A(에이전트 간 작업 전달) 같은 와이어 포맷 프로토콜), agent fleet(N개 에이전트가 같은 컨텍스트를 중복해 재발견하는 비용, 홉이 많은 토폴로지의 일관성 붕괴, 동료 출력을 채점할 때의 사회적 편향, 에이전트별 커널 격리) 중 하나다.
- 프레임워크 비교: LangGraph, deepagents, CrewAI, AutoGen을 볼 때는 상태, 도구, 검색, 위임, 영속성, 런타임 정책 중 무엇을 명시적으로 드러내는지를 기준으로 삼는다.
정리 — 에이전트를 띄우기 전 체크리스트
1절의 “모델 호출이 이동을 실행하지는 않는다”와 9절의 “명령 결과만으로는 어떤 메커니즘이 막았는지 알 수 없다”는 같은 말이다. 모델의 말(요청, 자기 보고)과 시스템의 사실(실행 기록, 파일, 정책)을 떼어서 본다. 이 습관을 체크리스트로 옮기면 다음과 같다.
- 도구 요청을 실행하기 전에 이름과 인자를 코드로 검증하는가? 스키마는 보장이 아니다.
- “저장했습니다”, “실행했습니다”를 파일, 로그, 실행 기록과 대조하는가?
- 페르소나·규칙·메모리·스킬 파일에 누가 쓸 수 있는가? 읽기 전용 모드는 소유자를 막지 못한다.
- cron 작업과 heartbeat처럼 사람 없이 도는 트리거는 무엇을 읽고 무엇을 쓰는가?
- control plane 토큰의 범위는 무엇이고, 그 토큰을 누가 읽을 수 있는가?
- 활성 정책을 직접 읽고, 예측과 실측을 비교했는가?
- 비공개 데이터, 신뢰할 수 없는 입력, 외부 통신 중 적어도 하나를 하네스나 애플리케이션 계층에서 끊었는가?
참고 자료
에이전트 패턴
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models (2022)
- Xu et al., ReWOO: Decoupling Reasoning from Observations (2023)
- Lilian Weng, LLM Powered Autonomous Agents (2023)
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts (2023)
- Model Context Protocol, Security Best Practices
검색
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering (2020) — 쿼리/구절 이중 인코더
- Edge et al., From Local to Global: A Graph RAG Approach to Query-Focused Summarization (2024)
보안
- Simon Willison, The lethal trifecta for AI agents (2025)
- Greshake et al., Not what you’ve signed up for (2023) — 간접 프롬프트 인젝션
- Saltzer & Schroeder, The Protection of Information in Computer Systems (1975)
- NIST, SP 800-207 Zero Trust Architecture
- OWASP, Top 10 for Agentic Applications
- Hermes Agent, Security
- Linux 커널 문서: Landlock · Seccomp BPF
이 글은 NVIDIA DLI 과정 「Securing Agents with OpenShell and NemoClaw」의 내용을 바탕으로, 특정 제품의 구현을 빼고 원리만 정리했다. 그림 1~5는 과정 저장소(Apache License 2.0)의 SVG를 라이트 테마로 렌더링한 것이다.